cat article
La mayoría de incidentes los provocamos nosotros
DATE: READ_TIME: 8m
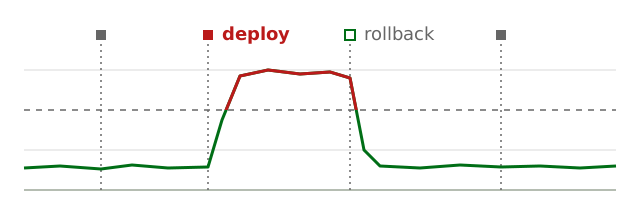
El sistema estaba bien hasta que lo tocamos
Imagina un martes a media mañana. Alguien sube un cambio de configuración pequeño: reducir el timeout de las llamadas a un servicio interno, de treinta segundos a cinco, porque las peticiones lentas estaban acaparando conexiones. El cambio está revisado, tiene sentido y en preproducción no da ningún problema.
En producción, ese servicio interno tarda más de cinco segundos en un porcentaje pequeño de peticiones: las de los clientes con más historial, que casualmente son los más grandes. Esas peticiones empiezan a fallar, el cliente reintenta, los reintentos añaden carga al servicio interno, que se vuelve más lento, lo que hace que fallen más peticiones. Veinte minutos después hay un incidente abierto y nadie lo relaciona todavía con un cambio de una línea en un fichero de configuración.
No ha fallado el hardware, ni la red, ni ha habido un pico de tráfico. El sistema llevaba semanas estable. Lo que ha cambiado es que alguien lo ha tocado.
El dato incómodo
Este patrón no es una casualidad. El libro de SRE de Google lo dice sin rodeos: aproximadamente el 70 % de las caídas se deben a cambios en un sistema en producción. Cualquiera que haya hecho guardias lo reconoce: la primera pregunta de casi todo incidente es “¿qué se ha desplegado?”, y lo habitual es que la respuesta explique buena parte de lo que está pasando.
Tiene lógica. Un sistema que no se toca acaba encontrando un equilibrio: los fallos que podía tener ya han salido y se han corregido, o se ha aprendido a convivir con ellos. Cada cambio rompe ese equilibrio y obliga al sistema a comportarse de una forma que nadie ha visto todavía en producción. Y “cambio” aquí es mucho más que un despliegue de código: también lo son una variable de configuración, una regla de firewall, una actualización del sistema operativo, una versión nueva de una dependencia, un certificado renovado o un ajuste en el autoscaling.
La conclusión fácil sería cambiar menos. Pero congelar un sistema solo pospone el problema: los cambios se acumulan, y cuando por fin se despliegan, llegan todos juntos, con mucho más riesgo y mucho menos contexto. La conclusión útil es otra: si el cambio es el principal origen de incidentes, el proceso de cambio es la principal herramienta de fiabilidad.
Cambios pequeños, aunque sean más
La primera palanca es el tamaño. Un despliegue con cuarenta cambios que falla obliga a averiguar cuál de los cuarenta ha sido, con el incidente abierto y la presión encima. Un despliegue con un solo cambio que falla ya trae la respuesta.
Desplegar a menudo y en piezas pequeñas parece más arriesgado porque hay más despliegues, pero cada uno es mucho más fácil de entender, de vigilar y de deshacer. Es el mismo argumento que expliqué en que lo simple triunfe sobre lo fácil: juntar los cambios en un despliegue grande parece más fácil, pero mantenerlos separados es más simple, y es lo simple lo que se puede operar.
Que el cambio llegue primero a pocos
La segunda palanca es el alcance. Si el cambio del timeout hubiera llegado primero al 5 % del tráfico, el incidente habría afectado al 5 % de los clientes grandes durante unos minutos, y la comparación con el 95 % restante habría señalado al culpable casi sola.
Es lo que se llama despliegue progresivo, y tiene varias formas:
- Canary. El cambio va a una fracción pequeña de instancias o de tráfico, se compara su comportamiento con el resto y solo se amplía si las métricas aguantan.
- Por fases. Primero un entorno interno, luego una zona o una región, luego el resto. Cada fase es una oportunidad para detectar el problema con menos daño.
- Blue/green. Dos versiones completas en paralelo y un cambio del tráfico de una a otra, que se puede revertir con la misma facilidad.
Ninguna de las tres sirve de mucho si nadie mira lo que pasa en cada paso. El canary tiene que comparar las métricas que importan, las mismas que definen el SLO, y la decisión de seguir o parar debería ser automática siempre que se pueda. Hace unos meses escribí sobre SLOs y on-call: un presupuesto de error que se consume en el canary es la mejor señal para frenar un despliegue antes de que llegue a todos.
Separar desplegar de activar
La tercera palanca es desacoplar dos cosas que solemos hacer a la vez: poner código nuevo en producción y que ese código empiece a hacer algo. Con una feature flag, el código se despliega apagado y se activa después, por separado, para un grupo de usuarios o un porcentaje de tráfico.
La ventaja no es solo poder activarlo poco a poco. Es que apagarlo no requiere desplegar nada. Cuando algo va mal, la flag se apaga en segundos, mientras que un rollback de código pasa por el pipeline completo. En el incidente que llega en la factura proponía un interruptor parecido para degradar un agente que se dispara de coste: es la misma idea aplicada a cualquier cambio de comportamiento.
Las flags también tienen su coste. Cada una es una rama de código que hay que mantener y que algún día hay que borrar, y una flag olvidada durante dos años es deuda técnica. Pero es deuda que se paga con calma, no a las tres de la mañana.
Un rollback que funcione de verdad
Casi todos los equipos dicen que tienen rollback. Muchos menos lo han probado recientemente. Y un rollback que no se ha ensayado es solo una esperanza.
Hay cambios que se deshacen fácilmente y otros que no, y conviene saber de qué tipo es cada uno antes de desplegarlo, no después:
- Código sin estado. Volver a la versión anterior suele bastar, siempre que esa versión siga disponible y el pipeline permita desplegarla rápido.
- Migraciones de esquema. Una columna borrada no vuelve con un rollback. La forma segura es hacerlas en dos pasos compatibles: primero añadir lo nuevo y que el código funcione con lo viejo y lo nuevo a la vez; borrar lo viejo solo cuando nadie lo usa ya.
- Infraestructura. Un cambio en una regla de red o en un recurso gestionado con Terraform puede no tener vuelta atrás limpia, o tardar mucho más de lo que el incidente permite. Ahí el plan de vuelta atrás tiene que estar escrito antes de aplicar.
- Datos. Si el cambio ya ha escrito datos con el formato nuevo, volver al código antiguo puede romper la lectura. Este es el caso que más sorprende y el que más conviene pensar antes.
Una buena costumbre es que cada cambio que no se pueda deshacer con un rollback normal lleve escrito, en la propia petición de cambio, cómo se revierte y cuánto se tarda. Si nadie sabe responder, el cambio no está listo.
Y si quieres comprobar que esto funciona antes de necesitarlo, provocar el fallo a propósito es una forma excelente: es lo que propone el chaos engineering, y ensayar un rollback es probablemente el experimento más rentable de todos.
Ventanas de cambio y congelaciones
Las ventanas de cambio tienen mala fama porque recuerdan a comités y formularios, pero la idea de fondo es razonable: no desplegar cuando nadie va a estar mirando ni cuando el daño de un fallo sería mayor.
Lo que funciona en la práctica es bastante menos burocrático que un comité:
- No desplegar los viernes por la tarde, ni antes de un puente, ni cuando la persona de guardia ya ha terminado su jornada. No es superstición: es que el gap de detección crece cuando no hay nadie mirando, como contaba en el tiempo entre que algo falla y que alguien se entera.
- Congelar en los picos del negocio: el Black Friday de un comercio, el cierre de mes de un sistema de facturación. Durante esas semanas, solo entran correcciones urgentes.
- Que quien despliega se quede a ver el efecto. Un cambio no termina cuando el pipeline acaba en verde, sino cuando las métricas confirman que el sistema sigue bien.
El problema aparece cuando las congelaciones se alargan. Un equipo que no puede desplegar en tres semanas acumula tres semanas de cambios, y el primer despliegue después de la congelación es el más peligroso del año.
La pregunta de siempre en el postmortem
En los postmortems siempre se pregunta qué falló. En los incidentes provocados por un cambio, conviene añadir otras preguntas:
- ¿Qué cambio lo provocó, y cuánto tardamos en relacionarlo con el incidente?
- ¿El cambio llegó a todos a la vez, o había forma de que llegara primero a unos pocos?
- ¿Se pudo deshacer en minutos, o hubo que improvisar la vuelta atrás?
La primera es especialmente reveladora. Si cuesta relacionar un incidente con un cambio es porque los cambios no están a la vista: cada equipo despliega por su lado y no hay un sitio único donde ver qué se ha tocado en la última hora. Marcar los despliegues y los cambios de configuración en los mismos dashboards donde se miran las métricas es barato y ahorra mucho tiempo en cada incidente.
Cuatro preguntas antes de desplegar
Antes del próximo cambio, prueba a contestar estas cuatro. Si alguna no tiene respuesta, ahí está el trabajo pendiente:
- ¿Este cambio va solo, o va mezclado con otros?
- ¿Puede llegar primero a una parte pequeña del tráfico?
- ¿Se puede apagar sin desplegar nada?
- ¿Sé cómo deshacerlo y cuánto se tarda?
El despliegue no es el final del trabajo, sino el momento de más riesgo de todo el ciclo.
Artículos relacionados
Sobre el autor
José Manuel García Locubiche. Site Reliability Engineer y sysadmin, con certificación de AWS. Trabajo en sistemas escalables, automatización y fiabilidad, y en evidencia y trazabilidad forense sobre AWS.