cat article
El postmortem que nadie lee y el incidente que vuelve a pasar
DATE: READ_TIME: 5m
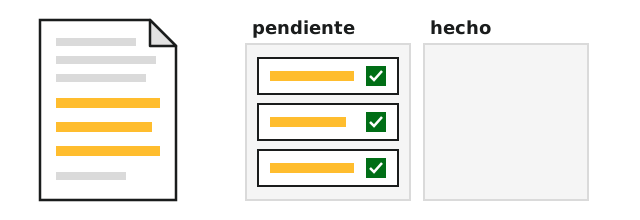
El documento estaba bien
Es una historia que cualquiera que haya hecho guardias reconoce. Un servicio se cae un jueves por la tarde durante cuarenta minutos. Se resuelve, y la semana siguiente el equipo escribe un postmortem impecable: cronología al minuto, gráficas, causa raíz, y una lista de doce acciones para que no vuelva a pasar. Hay reunión, todo el mundo asiente y el documento se guarda en la carpeta de postmortems.
Seis meses después, el mismo servicio se cae por el mismo motivo. Alguien busca el postmortem anterior y encuentra la solución en la acción número cuatro: “añadir un límite de conexiones al pool”. Nadie la hizo. No había dueño, no había fecha y no estaba en ningún backlog. Estaba en un documento que nadie volvió a abrir.
El problema no fue el postmortem, que estaba bien escrito. Fue tratarlo como el final del incidente, cuando en realidad es el principio del trabajo que lo evita.
Por qué se quedan en el cajón
Casi siempre por las mismas razones:
- Demasiadas acciones. Una lista de doce parece rigurosa, pero compite con todo lo demás que el equipo tiene que hacer. Las fáciles se hacen en una semana; las que de verdad importan, que suelen ser las difíciles, se van aplazando.
- Acciones sin dueño. “Mejorar la monitorización” no es una acción, es un deseo. Si no tiene una persona con nombre y una fecha, no la va a hacer nadie.
- Acciones fuera del flujo de trabajo. Si viven en el documento y no en el backlog donde el equipo planifica, no existen para la planificación.
- Nadie comprueba. Escribir el postmortem tiene un momento, una reunión y alguien que lo pide. Cerrar las acciones no tiene nada de eso.
Sin culpables, de verdad
Un postmortem sin culpables no consiste en no decir quién hizo qué. Consiste en partir de que nadie se equivocó a propósito y preguntarse cómo el sistema permitió que un error normal acabara en una caída.
La diferencia es práctica, no de buenos modales. Si la gente teme que el postmortem acabe señalándola, contará menos: no mencionará que dudó antes de ejecutar el comando, ni que el runbook estaba desactualizado y lo sabía. Y es justo esa información la que permite arreglar el sistema.
“Error humano” nunca debería ser la conclusión de un postmortem, sino el punto de partida. Si alguien desplegó un cambio que tumbó producción, las preguntas útiles son por qué el cambio llegó a todos a la vez, por qué no había forma rápida de deshacerlo y por qué nada lo detuvo antes. Es lo que contaba en la mayoría de incidentes los provocamos nosotros: el cambio es el origen habitual de las caídas, y la respuesta está en el proceso de cambio, no en la persona que lo hizo.
Pocas acciones, bien elegidas
En vez de una lista larga, funciona mejor quedarse con tres o cuatro acciones y que cada una responda a una de estas preguntas:
- ¿Cómo nos habríamos enterado antes? Una alerta que no existía, un umbral mal puesto, un canal donde alguien vio algo raro y no lo dijo.
- ¿Cómo lo habríamos parado antes? Un rollback más rápido, un interruptor para degradar, un runbook que alguien pueda seguir de madrugada.
- ¿Cómo evitamos que vuelva a pasar? El arreglo de fondo, que suele ser el más caro y el que más tiende a aplazarse.
Cada acción con un dueño, una fecha y un ticket en el mismo backlog que el resto del trabajo. Si una acción no cabe en esas condiciones, probablemente no es una acción todavía, sino algo que hay que investigar, y eso también puede ser un ticket.
Las preguntas que faltan
Hay preguntas que casi ningún postmortem se hace y que deberían ser fijas:
- ¿Cuánto tardamos en enterarnos? El tiempo de detección suele ser la parte más larga del incidente y la que menos se mira. Lo desarrollé en el tiempo entre que algo falla y que alguien se entera.
- ¿Qué cambio lo provocó y cuánto tardamos en relacionarlo? Si cuesta encontrar qué se tocó, el problema está en que los cambios no son visibles.
- ¿Cuánto costó? No solo en disponibilidad. Un incidente puede no tumbar nada y, aun así, salir muy caro, como contaba en el incidente que llega en la factura.
- ¿Había pasado antes? Si la respuesta es sí, lo importante del postmortem no es este incidente, sino por qué el anterior no sirvió.
Que alguien lo lea
Un postmortem tiene que tener lectores después de la reunión. Algunas costumbres sencillas ayudan:
- Revisar las acciones abiertas en una reunión que ya exista, no en una nueva. Cinco minutos cada dos semanas bastan para ver qué se ha cerrado y qué se ha atascado.
- Medir cuántas acciones se cierran. No el número de postmortems escritos, sino el porcentaje de acciones cerradas a los treinta y a los noventa días. Ese número dice más de la fiabilidad de un equipo que su SLO.
- Marcar los incidentes repetidos. Un incidente que se repite es un postmortem que no funcionó, y merece una conversación distinta.
- Compartirlos fuera del equipo. Los mejores postmortems son útiles para otros equipos que tienen los mismos patrones y todavía no han tenido el incidente.
La IA puede quitar buena parte del trabajo pesado: reconstruir la cronología a partir del canal del incidente, las alertas y los despliegues, o proponer un primer borrador. Es justo el tipo de tarea que encaja en lo que un modelo puede preparar para que una persona decida. Pero las conclusiones y las acciones son del equipo: un postmortem que nadie ha pensado tampoco lo va a leer nadie.
Si quieres profundizar, Anatomy of an Incident, que tengo en mi lista de libros, recorre el ciclo completo de un incidente, incluida esta parte que tantas veces se queda a medias.
Por dónde empezar
Si solo vas a hacer una cosa esta semana, abre los tres últimos postmortems de tu equipo y cuenta cuántas de sus acciones están cerradas. Ese número, más que cualquier plantilla nueva, te dice si los postmortems están sirviendo para algo. Lo demás es documentación: útil, pero no evita el siguiente incidente.
Artículos relacionados
Sobre el autor
José Manuel García Locubiche. Site Reliability Engineer y sysadmin, con certificación de AWS. Trabajo en sistemas escalables, automatización y fiabilidad, y en evidencia y trazabilidad forense sobre AWS.